среда, 25 января 2023 г.

Модели прогнозирования

 Велосипедисты на мосту: пример построения моделей прогнозирования
     Подробно рассматриваются различные  модели оценки плотности велосипедного движения через р. Рейн по мосту Кеннеди в Бонне. Исходными данными являются зарегистрированное ежедневное число велосипедистов (2015-2021 г.г)  и наблюдаемые метеорологические условия в тот же день (температура, интенсивность осадков, скорость ветра и др. -  всего 9 показателей).
      Эти данные анализируются под двумя углами зрения. В первой части сообщения  по полному технологическому циклу проводится подбор классической модели линейной регрессии. Сюда входит заполнение пропущенных значений, оценка мультиколлинеарности комплекса исходных предикторов, выявление возможной нелинейности их связи с откликом, селекция наиболее информативного набора метеорологических переменных. Были построены две наилучших линейных модели: первая - по внутреннему информационному AIC-критерию, вторая - из условия максимальной точности прогноза (минимума ошибки предсказания) на независимой контрольной выборке. Выполнялись также выявление выбросов, оценка  статистической значимости моделей и их проверка на соответствие основным предпосылкам линейной регрессии. Параллельно на тех же переменных строились модель случайного леса (Random Forrest) , многослойный персептрон и рекуррентная нейронная сеть Элмана.   
      Во второй части сообщения в тестируемые модели включались  переменные,  традиционные для временных рядов, и описывающие автокорреляцию, многолетний тренд а также недельные и сезонные периодические составляющие. Без особого успеха на основе этих функций строились модели экспоненциального сглаживания (Хольта-Винтерса), авторегрессии и скользящего среднего (ARIMA), а  также многослойный персептрон (NNAR) и машина с экстремальным обучением (ELM). Существенный прогресс произошел при использовании обобщенных аддитивных моделей (GAM) на основе пакета пакета Prophet ("пророк"). Последовательное включение в модель, наряду с функциями, описывающими кусочно-линейный тренд и сезонные компоненты на основе аппроксимации рядами Фурье,  дополнительных регрессоров, связанных с важнейшими погодными условиями и эффектами праздничных дней и особых периодов, привело к созданию хорошо интерпретируемых моделей, обладающих одновременно неплохой ошибкой предсказания. Однако, вне конкуренции по критерию качества прогноза оказались метода самоорганизации: модель группового учета аргументов (МГУА - GMDH) и  рекуррентная нейронная сеть Элмана на основе исходных переменных смешанного состава (7 лаговых переменных, "свертка" из 20 гармоник быстрого дискретного преобразования Фурье  и трех метеорологических факторов).
            Текст сообщения в формате PDF может быть загружен с ресурса
http://www.ievbras.ru/ecostat/Kiril/R/Blog/27_Velo.pdf  
Исходные данные, обрабатываемые с помощью скриптов, представленных в сообщении,  можно скачать  с http://www.ievbras.ru/ecostat/Kiril/R/Blog/Velo.RData  .


четверг, 1 декабря 2022 г.

Ассоциативность видов on-line

  Веб-приложение Shinny для анализа ассоциативности объектов в сетевых структурах 

     Экологические данные часто представлены таблицами встречаемости (1) или отсутствия (0) того или иного вида в пробах или местообитаниях. Для таких бинарных пространств описан многочисленный класс мер связи между каждой парой объектов, которые обычно основаны на  частоте их относительной совместной встречаемости  (индексы Жаккара, Съеренсена, Охаи и т.д.).  Общей проблемой этих эвристических мер является отсутствие четкого критерия оценки их статистической значимости на основе стандартной процедуры проверки гипотез. Если, например, был рассчитан коэффициент Съеренсена S = 0.45, то у исследователя нет оснований утверждать, что сравниваемые виды имеют сходное распределение  по изучаемой территории, поскольку их кажущая связь может быть обусловлена случайными причинами.
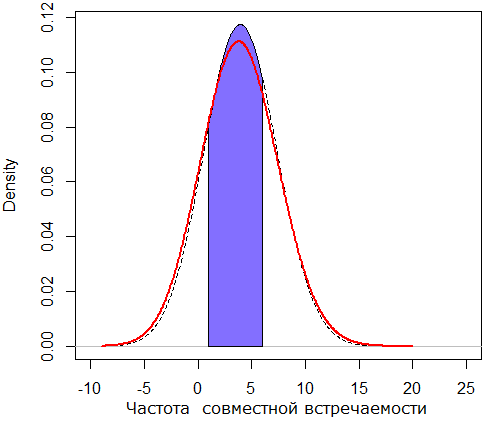
      Настоящее сообщение описывает методику оценки значимости ассоциаций для пар видов путем моделирования эмпирических данных дискретными распределениями Х – гипергеометрическим или биномиальным. Если наблюдаемая вероятность Р(х) совместного обнаружения двух видов в x из N проб отвечает условию    
Р(х) = P [X £ x] > (1 – pcrit) , то виды считаются положительно ассоциированными на уровне статистической значимости pcrit. Если справедливо условие   
Р(х) = P[X > x] > (1 – pcrit), то принимается предположение об отрицательной ассоциативности видов, т.е. их несовместимости. В противном случае считается, что распределение видов по участкам независимо друг от друга, а частота их совместного появления не отличается от случайной.
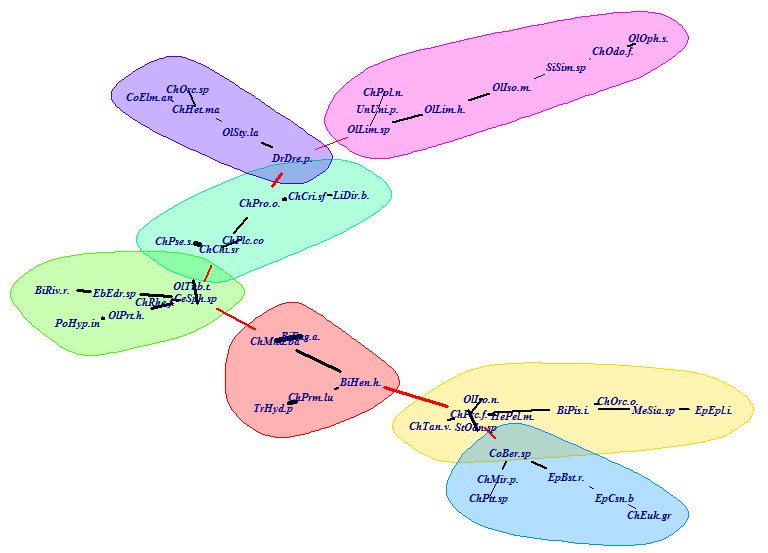
      Для визуализации всех статистически значимых связей в изучаемом экологическом сообществе  удобно использовать сеть, в которой узлы представляют выявленные виды сообщества, а ребра с весами  Р(х) – ассоциации между парами видов, превышающие уровень доверительной вероятности при анализе заданного дискретного распределения. Для удобства содержательной интерпретации конфигурации графа целесообразно осуществить группировку его вершин, исходя из условий максимальной компактности и связности выделяемых кластеров.
      Для реализации всей описанной методики вашему вниманию предлагается интерактивное web-приложение на базе пакета Shinny (разработчик - н.с. ИБВВ РАН Д.Г. Селезнев), которое позволяет провести обработку данных без загрузки статистической среды R. Любой заинтересованный исследователь может обратиться on-line с помощью своего Интернет-браузера к его клиентской части по URL  http://apps.ibiw.ru/coobs загрузить файл со своими исходными данными и получить табличные и графические файлы с результатами расчетов.
     Приложение выполняет визуализацию различных вариантов графов построенной сети с использованием функционала пакета igraph, при этом  настройка изображения выполняется интерактивно с помощью набора параметров, выведенных на панель управления. Пользователь также может выбрать подходящий алгоритм кластеризации вершин графа из 7 возможных методов, рекомендуемых в научной литературе.
      Текст сообщения, содержащий описание методики и особенностей работы с web-приложением, может быть загружен с ресурса
 

четверг, 3 ноября 2022 г.

Визуализация сетей iGraph

 Визуализация корреляционных сетей с использованием пакета iGraph

     Эффективным методом изучения  большинства естественных и социальных систем является их графическое представление в форме сети - набора объектов (вершин или узлов графа), объединенных логическими или физическими связями (ребрами). Визуальное представление сетей позволяет получить компактную, целостную и наглядную картину явлений, происходящих в системе.  Формальный анализ структуры сформированного графа различными математическими методами дает возможность решать такие задачи как отбор наиболее информативных звеньев системы, выделение компактных сообществ и кластеризация, нахождение дерева кратчайшего пути и построение сети максимальной пропускной способности. 
    Ранее мы рассматривали моделирование корреляционных связей в экологических сообществах с помощью сетей, построенных с использованием пакета qgraph. В настоящем сообщении мы продолжим этот разговор, рассматривая работу с пакетом igraph, который, в принципе, предназначен для сходных целей, но и имеет существенные концептуальные отличия. Если qgraph ориентирован, в основном, на пристальный анализ корреляционных связей, то igraph имеет более универсальный характер и включает развитый аппарат настройки свойств графической визуализации. 
      В качестве  примера мы используем корреляционные матрицы, сформированные по результатам многолетнего изучения донных сообществ малых и средних рек бассейна Средней и Нижней Волги, а также данные мониторинга абиотических факторов в этом регионе. Полный комплект исходных данных можно скачать здесь . 
      Текст сообщения в формате PDF может быть загружен с ресурса

среда, 27 апреля 2022 г.

Структура фитоценозов

Анализ пространственной структуры растительных сообществ с использованием пакетов R
 
     В этом сообщении мы сталкиваемся с определенным феноменом:  Мартынова Анна, ученица 10 кл. из г. Кумертау, самостоятельно сделала геоботаническое описание пробной площадки в башкирской степи, написала необходимые скрипты на языке R, выполнила расчеты по анализу пространственной структуры фитоценоза, осмыслила их и написала вполне полноценную научную статью (можно скачать здесь). Вспомните, что вы сами делали в 17 лет!!!
     Сообщение состоит из 5 разделов  по материалам работы А.Мартыновой:
1. Подготовка и предварительный анализ фрейма с результатами геоботанических наблюдений (файл с исходными данными можно скачать здесь).
2. Анализ пространственной структуры фитоценоза: построение карт популяционных плотностей на основе пакета spatstat, выделение доминирующих видов, оценка корреляционных связей и т.д.
3. Проверка гипотезы о характере пространственного размещения точек с использованием функций Рипли.
4. Построение пространственных кластеров с группировка по видовому составу и разнообразию.
5. Анализ пространственной изменчивости видового состава с использованием индексов zeta-разнообразия и пакета zetadiv (представлено В.Шитиковым). 
 
Текст сообщения в формате PDF может быть загружен с ресурса
 

пятница, 24 сентября 2021 г.

Экологические ниши

Экологические ниши, их современная интерпретация и моделирование с использованием пакета  ecospat

 Экологическая ниша - термин, пользующийся странной популярностью:  многие употребляют, но немногие задумываются над его смыслом.  Чем отличается ниша Гринелла от ниши Элтона? Стоит ли рассуждать о реализованных нишах, если примеры их построения практически неизвестны?  В этом сообщении мы делаем достаточно подробный обзор статей  Дж. Соберона (Soberon) и А. Петерсона (Peterson), последовательно пытающихся разобраться в этих непростых вопросах  (правда на уровне простеньких картинок, иллюстрирующих пересечения неких умозрительных множеств). 
Но для тех, кому захочется самому  построить гринеллевскую фундаментальную нишу, мы рекомендуем обратить внимание на R-пакет  ecospat.  Сразу оговоримся, что многое в этом пакете не понравилось. Раздел "предварительного анализа данных" вроде бы содержит полезные функции разведывательных операций, но напоминает "окрошечную смесь" из пространственной автоковариации, филогенетических индексов, оценок сопряженности встречаемости видов, сходства географических пространств и чего-то еще маловменяемого. Все делалось как-то впопыхах и лучше для выполнения этих расчетов обращаться к специализированным пакетам. Раздел, посвященный  моделям коллективного прогнозирования, может оказаться полезным (наряду с пакетом ForecastCombinations и многими другими на ту же тему) именно в случае географического прогнозирования. Но при выполнении вычислений выводится большое количество мало нужной информации, тогда как ко многим ключевым показателям добраться не всегда удобно. Раздел, посвященный пространственно-обусловленному моделированию совокупности видов (SESAM) также оказывает несколько отстраненное впечатление. 
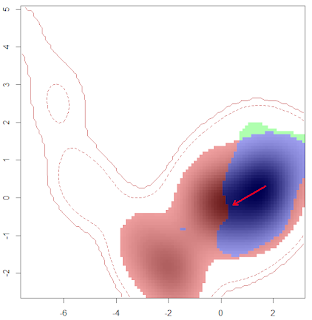
При всем этом, функции построения пространства ниш и оценки их перекрытия выполнены на весьма приличном уровне.  Пакет R-функций ecospat (Broennimann et al., 2012; Di Cola et al., 2017) дает возможность построить произвольно сглаженную поверхность индекса экологической пригодности в осях двух главных компонент, основываясь на традиционной таблице «местообитания – переменные среды», что позволяет учесть полный набор факторов. Это - важный момент, поскольку в известных пакетах virtualspecies,  dismo и др., ортогональное пространство наименьшей вариации (РС) формируется на основе растров геоклиматической информации, представленной в ячейках ("пикселах") равномерной сетки географических координат высокого разрешения. Представить в такой форме локальные характеристики речных биотопов, такие как состав химических ингредиентов, гидрологические параметры водотока, тип донного грунта и т.д., традиционно ключевые для гидробиологии, представляется невозможным. 
В нашем сообщении мы подробно рассматриваем функции построения и перекрытия одномерных и двумерных ниш на собственном примере - гидробиологической съемке донных сообществ в малых реках бассейна Средней и Нижней Волги.
 
        Текст сообщения в формате PDF может быть загружен с ресурса
http://www.ievbras.ru/ecostat/Kiril/R/Blog/23_Niche.pdf        
Исходные данные, обрабатываемые с помошью скриптов, представленных в сообщении  можно скачать  с http://www.ievbras.ru/ecostat/Kiril/R/Blog/WB_niche.RData  .

воскресенье, 20 июня 2021 г.

Деревья таксономии

Систематика, таксономия, филогенетика

      В настоящем сообщении  рассматриваются возможности анализа таксономической структуры экологических  сообществ на основе филогенетических представлений.  В качестве примера мы оцениваем степень влияния такого ведущего фактора водной среды как минерализация на тесноту родственных связей между видами макрозообентоса.
      Особое внимание обращается на подготовку исходных данных в форме таксономической таблицы. Показано, как с помощью функций пакета  taxize можно с использованием различных всемирных баз данных уточнить современные названия видов или получить идентификаторы  более высоких таксономических уровней вплоть до superKingdom. Приводятся скрипты, как можно выполнить тестирование и корректировку названий таксонов в исходной "сырой"  таблице.
     Мы придерживаемся точки зрения, что в классических задачах экологии сообществ смысл использования филогенетических деревьев с датированием эволюционных событий далеко не  очевиден. Нет никаких оснований непосредственно связывать закономерности формирования структуры сообщества из уже существующих видов с их эволюционной историей.   Однако молекулярная генетика и биоинформатика к настоящему времени накопили столь внушительный арсенал средств сравнительного филогенетического анализа, что всемерная апробация этих методов в смежных отраслях биологии и экологии может только приветствоваться.
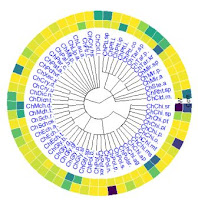
     В представленном сообщении речь идет не о филогенетических деревьях, а о таксономических кладограммах, основанных на актуальной биологической систематике. Мы построили дерево, узлами которых служат конкретные таксоны разного ранга, а длина каждой ветви принималась равной таксономическому расстоянию по  Clarke-Warwick . И если иногда это дерево трактовалось как филогенетическое, то это просто условности применения филогенетических методов. Легко показать (Chao et al. 2014), что для наших кладограмм вполне корректно использование большинства математических выражений и процедур анализа топологии филогенетических деревьев с датированием эволюционных событий. В частности, нами приводятся расчеты  филогенетического сигнала, оценивающего  насколько «родственные виды походят друг на друга больше, чем виды, случайно взятые из того же дерева». Мера филогенетического сигнала в отношении соленосной толерантности видов оценивалась по двум статистикам - лямбда Пагеля и К Блумберга, которые равны нулю при отсутствии зависимости и возрастают по мере увеличения корреляционной связи между степенью таксономического родства и тестируемой характеристикой.
     Другое дерево систематики мы построили с неопределенными длинами ветвей. Эта кладограмма использовалась для визуализации того, как среднегрупповая соленосная толерантность меняется для разных клад, объединяющих подмножества таксонов. Для этого применялись как скрипты собственной разработки, так и функции пакетов phytools и ggtree.
      Текст сообщения в формате PDF может быть загружен с ресурса
http://www.ievbras.ru/ecostat/Kiril/R/Blog/22_Phylogen.pdf 

понедельник, 22 марта 2021 г.

Индексы нестабильности

Анализ статистической связи между обилием видов и абиотическими факторами с использованием индексов нестабильности

     Коллектив испанских экологов из Университета в г. Виго, возглавляемый К.Гисандом, успешно использует в своих исследованиях различные версии индексов нестабильности (Instability index). В настоящем сообщении приводятся скрипты на языке R, позволяющие рассчитать и выполнить дальнейший анализ этих индексов на основе формулы дивергенции Кульбака-Лейблера, т.е. по сути найти  тот информационный выигрыш, который исследователь получает, рассматривая конкретную реализацию случайной величины вместо ее выборочного среднего значения.
     В качестве примера расчетов мы использовали данные, сформированные по результатам многолетнего изучения донных сообществ малых и средних рек бассейна Средней и Нижней Волги, а также мониторинга абиотических факторов в этом регионе.  Исходные таблицы размещены в файле "InStab_dat.RData", который необходимо загрузить с общедоступного ресурса http://www.ievbras.ru/ecostat/Kiril/R/Blog/InStab_dat.RData и поместить в рабочий каталог среды R.
     На первом этапе анализа рассчитывается комплект индексов нестабильности для каждого из 8 абиотических показателей и каждого из 147 видов макрозообентоса применительно к обследованным 132 участкам рек. На втором этапе строятся модели Random Forrest зависимости величины индекса для каждого вида  от от нестабильности факторов среды и оцениваются показатели их сравнительной важности (importance). На третьем этапе строятся графики и карты, позволяющие интерпретировать выполненные расчеты.
Расширенная версия сообщения, опубликованная после 20 июня 2021 г., включает введение и подробное обсуждение проблемы  и полученных результатов

Текст сообщения в формате PDF может быть загружен с ресурса  
http://www.ievbras.ru/ecostat/Kiril/R/Blog/21_Instab.pdf 

четверг, 11 февраля 2021 г.

Radiant

 Radiant – интерактивное статистическое веб-приложение

Представлен Radiant - интерактивное приложение для проведения статистического анализа, использующее веб-интерфейс, независимое от  платформы или операционной системы пользователя (Windows 7 - 10, Mac или Linux). Оно не требует никакой дополнительной инсталляции и может быть запущено в любом интернет-браузере (Explorer, Google Chrome, FireFox, Opera) путем ввода адресной строки

 https://vnijs.shinyapps.io/radiant

      Веб-интерфейс, поддерживаемый средствами пакета Shiny (см. сообщение https://stok1946.blogspot.com/2021/01/shiny.html), дает возможность решать с помощью Radiant широкий круг задач анализа данных, не прибегая фактически к использованию каких-либо кодов команд. Освоить работу с приложением чрезвычайно легко даже неподготовленному пользователю, в том числе, благодаря подробной документации, подготовленной разработчиком Radiant Винсентом Найджем (Vincent Nijs) - http://radiant-rstats.github.io/radiant.  Она содержит описание 5 основных групп функций статистического анализа:   
  •  Radiant.Data ("Данные") включает интерфейсы для загрузки, сохранения, просмотра, визуализации, обобщения, преобразования и объединения данных.
  •  Radiant.Design ("План") включает в себя инструменты для проектирования эксперимента, рандомизации и расчета необходимого объема выборки.
  •  Radiant.Basics ("Основной") содержит функции для расчета вероятностей, моделирования центральной предельной теоремы, сравнения средних и пропорций, тестирования соответствия, перекрестных связей и корреляции.
  •  Radiant.Model ("Модели") включает интерфейсы для создания различных моделей: линейной и логистической регрессии, нейронных сетей, иерархических моделей, анализа решений и имитации.
  •  Radiant.Multivariate ("Многомерный") включает интерфейсы для различных вариантов факторного и кластерного анализа.
Приложение написано в кодах R и легко интегрируется в ее среду. Средства Radiant.Report ("Отчет") содержат функциональные возможности для создания тиражируемых отчетов по результатам анализа, выполненного в веб-приложении. Установив пакет Radiant, можно использовать все его функции в собственных скриптах обработки данных, или развернуть собственный клон веб-приложения.
 
      Мы выполнили   сокращенную адаптацию документации Radiant для широкого круга пользователей, мало знакомых с программированием на языке R, и представляем перевод на русский язык руководства по использованию перечисленных выше разделов функций. Текст сообщения в формате PDF может быть загружен с ресурса  
http://www.ievbras.ru/ecostat/Kiril/R/Blog/20_Radiant.pdf 

суббота, 9 января 2021 г.

Приложения Shiny

Интерактивные веб-приложения с Shiny

     Пакет Shiny, созданный разработчиками RStudio, представляет собой  эффективное средство создания интерактивных веб-приложений на языке R, поддерживающих современные клиент-серверные технологии.  Сервер (удаленный компьютер), на котором установлена статистическая среда  со всеми необходимыми пакетами, транслирует команды языка R в блоки HTML-кода, формирующие веб-страницу на клиентском компьютере, на котором достаточно установить только интернет-браузер. Созданная веб-страница включает, как правило, реактивные компоненты пользовательского интерфейса - графические виджеты, с помощью которых  клиент может ввести исходные данные, установить необходимые параметры расчетов или выполнить иные действия. Сервер отслеживает все изменения на клиентской стороне и изменяет выходные значения по всей цепочке выражений, которые немедленно обновляются браузером на клиентской стороне.
     Весь пользовательский веб-интерфейс приложения Shiny может быть описан полностью с помощью средств языка R, но для большей гибкости может включать фрагменты кодов HTML, CSS или JavaScript. Разрабатывать Shiny-приложения можно в любой версии среды R (консольная версия R, Rgui для Windows или Mac, ESS, StatET, RStudio и другие). В сообщении ниже дается краткое описание основных компонентов пакета Shiny и правила их использования, а также приведены некоторые практические примеры.
     В разделе"1. Краткий курс Shiny" описывается структура  Shiny – скриптов, наиболее употребимые макеты страницы и средства пользовательского интерфейса (виджеты клиентской части). Представлены также функции server() и механизм обработки прерываний, основанный на принципах "реактивного программирования".   Описана методика продвижения  Shiny-приложений в интернете, основанная на двух подходах. Первый основан на совмещении клиента и сервера на одном компьютере (или в одной сети) и пользователь запускает скрипты собственного (а также скачанного или размещенного на github-серверах) приложения из среды R. Второй основан на развертывании серверной части приложения на удаленном компьютере и клиент может подключаться к нему, располагая лишь адресом URL. Все эти процедуры могут быть выполнены с помощью функций пакета Shiny.
     Во втором разделе приведены некоторые примеры приложений  Shiny  и представлены их скрипты. В двух примерах экологического  характера показаны подбор статистических распределений, управление таблицами данных, выполнение многомерного анализа соответствий (СА), построение ранговых моделей обилия видов и т.д.  Приведен текст скрипта, вычисляющего 22 индекса видового разнообразия.
       Еще два примера, могут быть интересны не только экологам:
   Пример 3. Скачивание  Google-таблицы со списком  аудиокниг из архива на Telegram (канал  https://t.me/arxiv_audio_books ) , содержащем более 36000 наименований. Попытка организации поиска  интересующих авторов и чтецов.
    Пример 4. Имитация игры в американскую рулетку и сравнительная оценка эффективности систем "На красное", "На номер",Мартингейла и Лабушера.  
 
Текст сообщения в формате PDF может быть загружен с ресурса 
  

вторник, 24 ноября 2020 г.

Модели SDM

 Модели пространственного распределения видов

      В нашем предыдущем сообщении Визуализация на картах: мы рассматривали задачу двумерной интерполяции произвольного показателя и отображение его на картах.     В настоящем сообщении мы пойдем дальше  и обсудим проблему выделения областей встречаемости (или ареалов) биологических видов. Во введении и далее по тексту  подробно рассматриваются основные теоретические концепции построения моделей пространственного распределения видов  (SDM - species distribution models) и приводится достаточно обширный список литературных ссылок.

      Для построения моделей в наших примерах используются те же картографические объекты и таблицы данных, что и в предыдущем сообщении. Однако  в число предикторов моделей, кроме характеристик локальных биотопов исследованных рек, включен также набор геоморфологических и климатических показателей региона, скачиваемый с сервера свободно распространяемой информации WorldClim. Показаны основные функции работы с геоинформационными объектами типа raster.

Рассматриваются четыре основных направления построения  моделей SDM:

  • для данных типа "только наличие" вида (presence-only) показано применение моделей, основанных на формировании случайных наборов фоновых точек (pseudo-absence), которые реализуются программой BIOCLM из пакета dismo и модулем MaxEnt, использующем метод максимальной энтропии; 
  • распределение "виртуального вида" (virtual species) абстрагируется от данных экспедиционных исследований о встречаемости таксонов и моделирует ячеистую структуру в n-мерном пространстве, основываясь исключительно на факторах среды априори заданной фундаментальной экологической ниши;  
  • для данных типа "наличие-отсутствие вида" (presence-absence) показано построение различных моделей регрессионного типа: а) обычной линейной модели, б) модели lasso с использованием регуляризации, в) модели частных наименьших квадратов в редуцированном пространстве переменных, г) случайного леса (Random Forest),  д) по методу опорных векторов с радиальным ядром, е) байесовской модели со смешанными параметрами, ж) коллективной модели; 
  •  при моделировании совместного распределения ансамбля видов (JSDM - join species distribution models) описывается структура многомерной байесовской иерархической модели, представленной в составе пакета Hmsc и включающей пространственную автокорреляцию и филогенетический сигнал.

Текст сообщения в формате PDF может быть загружен с ресурса
http://www.ievbras.ru/ecostat/Kiril/R/Blog/18_SDM.pdf 


четверг, 10 сентября 2020 г.

Визуализация на картах

Интерполяция и визуализация пространственных данных

   Рассматривается процесс создания совокупности тематических карт, позволяющий отобразить и проанализировать результаты  пространственного распределения исследуемых показателей.
      Сообщение состоит из четырех разделов и основано на примере гидробиологической съемки бентоса в малых реках Среднего и Нижнего Поволжья:
      1. Подготовка базового картографического слоя. Основная карта (подложка) включает речную сеть, границы административных областей и важнейшие города. Показывается загрузка бокса данных из свободно распространяемых ресурсов  Natural  Earth, GADM  и  OpenStreetMap. Карта формируется  в виде слоев графического пакета ggplot2.
      2. Наложение на карту информации по теме исследования в виде точек, мозаики и двумерной плотности статистического распределения.  Рассматривается моделирование глобального тренда плоскостью и оценивается его статистическая значимость на основе рандомизации.
      3. Аппроксимация и интерполяция пространственного распределения показателя Z с использованием детерминированных методов: полиномов, локальной регрессии, обратных взвешенных расстояний, триангуляции (метод Акимы) и иерархических базисных сплайнов.
4. Построение вариограмм и интерполяция показателя с помощью геостатистических методов (ординарного кригинга).
      Текст сообщения в формате PDF может быть загружен с ресурса
http://www.ievbras.ru/ecostat/Kiril/R/Blog/17_MetMap.pdf 
      Исходные данные, обрабатываемые с помошью скриптов, представленных в сообщении  можно скачать  с 
http://www.ievbras.ru/ecostat/Kiril/R/Blog/WB_data.RData
      Готовую карту после отработки скриптов раздела 1 (если его процедуры не представляют интереса) также можно скачать с
http://www.ievbras.ru/ecostat/Kiril/R/Blog/WB_map.RData
 

среда, 22 апреля 2020 г.

Имитационные модели

Имитационные модели для анализа процессов в экологических сообществах

Подробно рассматриваются коды скриптов R для реализации различных имитационных моделей, осуществляющих анализ  четырех основных процессов (отбор, дрейф, рассеяние, видообразование), которые определяют динамику формирования экологических сообществ, в том числе:
 - имитация стохастической  динамики локального нейтрального  сообщества;
 - моделирование различных типов динамики конкурентного отбора видов в условиях различной их приспособляемости (fitness) к факторам среды; 
 - моделирование периодических процессов, флуктуируюших во времени;
 - анализ условий стабильного совместного сосуществования видов мета-сообщества в результате компромисса между конкуренцией (отбором) и колонизацией (рассеянием);
 - оценка динамики процессов образования регионального пула видов на "материке" и моделирование характера изменчивости видового состава локальных сообществ на "островах" с использованием концепции МакАртура-Вильсона (1967).
 Все цитируемые теоретические обоснования и дополнительные материалы по использованию представленных имитационных моделей содержатся в книге канадского эколога М.Велленда "Теория экологических сообществ" (Vellend M. The theory of ecological communities. Princeton University Press, 2016. 224 р.  - www.ievbras.ru/ecostat/Kiril/R/Biblio_N/R_Eng/Vellend2016.pdf).
Примечание: на фото - автор книги за сбором одуванчиков в канадских лесах.

Текст сообщения в формате PDF может быть загружен с ресурса
http://www.ievbras.ru/ecostat/Kiril/R/Blog/16_Vellend.pdf 

среда, 12 февраля 2020 г.

Пакеты R по экологии

Анализ данных в экологии: обзор задач, решаемых R

Gavin Simpson «CRAN Task View: Analysis of Ecological and Environmental Data». 16-01-2020.    https://CRAN.R-project.org/view=Environmetrics

Представляемый перевод обзора  содержит краткий список пакетов, доступных в CRAN, которые являются основой для создания различных статистических моделей в экологических исследованиях и получили широкое применение при изучении различных процессов окружающей среды. Пакеты сгруппированы по темам и типам анализа. 
Текст сообщения в формате PDF может быть загружен с ресурса
http://www.ievbras.ru/ecostat/Kiril/R/Blog/15_View.pdf 

среда, 22 января 2020 г.

Визуализация корреляций

Моделирование корреляционных связей в сообществе с помощью сетей

Использование корреляционных графов (плеяд Терентьева) имеет давнюю традицию для визуализации и анализа связей в сообществах.  Настоящее сообщение рассматривает технику применения функций пакета qgraph версии 1.6.4  на примере анализа таксономической структуры сообществ водных организмов по серии гидробиологических проб. В нем рассматривается целый круг методических вопросов, в том числе:
  • различные формы и элементы дизайна, используемые при построении насыщенных графов корреляционных сетей;
  • выделение статистически значимых связей между узлами;
  • способы задания группировки узлов и использование методов многомерного анализа для целенаправленной ординации и кластеризации данных;
  • частные корреляционные сети и пути решения проблем, связанные с отрицательной определенностью корреляционной матрицы;
  • использование препроцессинга исходного пространства признаков с использованием алгоритма Boruta;
  • нахождение оптимального графа сети с использованием пошаговой процедуры и информационных критериев;
  • оптимизация частной корреляционной сети на основе адаптивного алгоритма регуляризации лассо.
Показано, что пакет qgraph  является  не только превосходным инструментом визуализации сетей, но и содержит полный набор графоаналитических методов, включая «разрежение» взвешенных матриц данных и оптимизацию структуры формируемого графа.
Текст сообщения в формате PDF может быть загружен с ресурса
http://www.ievbras.ru/ecostat/Kiril/R/Blog/14_QGraph.pdf 

четверг, 5 декабря 2019 г.

Бинарные временные ряды


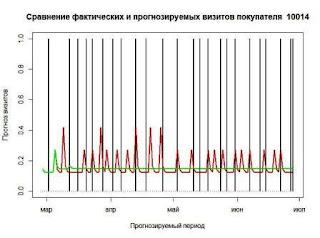
Рассматриваются проблемы форвардного прогнозирования  значений бинарных временных рядов (binary time series predicting). В качестве рабочего примера  использовался фрагмент базы данных о частоте посещений одним из покупателей в течение трех лет  магазинов популярной российской кампании (может быть загружен с ресурса  
http://www.ievbras.ru/ecostat/Kiril/R/Blog/POS10x.RData ) .
     Ставилась задача предсказания дат наиболее вероятных визитов в течение некоторого тестируемого периода. Наилучшее решение искалось с использованием трех основных концепций построения моделей временных рядов:
        1. В классе обобщенных моделей, использующих пространства состояний (Generalized State Space Modeling) . С помощью функций пакета glarma (Generalized Linear AutoRegressive Moving Average) выполнялось построение линейных моделей авторегрессии - скользящего среднего для дискретной случайной величины, имеющей Бернулли, биномиальное, Пуассона или отрицательное биномиальное распределение. Другой вариант моделей того же бинарного временного ряда был получен с использованием пакета tscount.
       2. На основе байесовской структурной модели временных рядов (Bayesian structural time series). Расчеты выполнялись с использованием функций, реализованных в пакете bsts.
     3. С использованием однородных марковских цепей дискретного временного ряда.  Классический подход к моделированию марковских процессов (без какого-либо ощутимого успеха) был  апробирован на основе пакета  markovchain.  Значительно более впечатляющие результаты прогнозирования были получены  при использовании другого пакета depmixS4, который реализует в среде программирования R общие принципы формирования стандартных и скрытых моделей марковских цепей. 
     Результаты тестов на форвардное прогнозирование временного ряда, полученные вышеперечисленными пятью пакетами, сравнивались с простейшим способом предсказания на основе оценок вероятностной плотности распределения событий. 
С методической точки зрения при  могут быть интересны некоторые приемы обработки исходных данных на основе библиотеки  "tidy data" Х.Викхэма 

Текст сообщения в формате PDF может быть загружен с ресурса
http://www.ievbras.ru/ecostat/Kiril/R/Blog/13_BTS.pdf 

понедельник, 19 августа 2019 г.

Потоки и тибблы

Конвейеры, тибблы и другие средства управления данными в R

        Обсуждаются современные концепции управления "аккуратными" данными, оформленные  Х.Викхэмом в виде философии "tidy data" и реализованные в пакете tidyverse. Мы приводим свободную компиляцию (с привлечением иных источников) некоторых разделов книги (Wickham, Grolemund, 2017). Большинство примеров, представленных нами, также заимствованы из этой книги. 
     
Сообщение включает следующее содержание:
    1. Рассматривается идеология создания "конвейеров" (или "трубопроводов" - pipeline), представляющих стандартизированные цепочки последовательных действий по обработке данных, и представлены новые объекты данных "тибблы" (tibbles), являющиеся усовершенствованным вариантом таблиц data.frame. 
   2. Описаны пять ключевых функций  пакета  dplyr, которые позволяют решить большинство задач, связанных с обработкой данных (выборка, сортировка, группировка, создание новых переменных). Приводятся многочисленные примеры создаваемых конвейеров.
    3. Представлены принципы организации запросов к реляционным базам данных с использованием библиотеки tidyverse.

Адрес для доступа к PDF-файлу сообщения -
http://www.ievbras.ru/ecostat/Kiril/R/Blog/12_Tidyverse.pdf


вторник, 9 июля 2019 г.

Адекватность

Оценка адекватности регрессионных моделей

 В настоящем сообщении обсуждаются способы оценки адекватности, которая определяет степень применимости моделей для каких-то практических действий (прогнозирования, управления и проч.). Рассматривается два набора тестов, по результатам которых модель признается неадекватной, если отклоняются следующие утверждения нулевой гипотезы:
  1. Постоянство остаточной дисперсии модели (гомоскедастичность);  случайность и независимость  выборочных остатков; равенство нулю их среднего  и согласие с  распределением по постулируемому закону;
   2. Незначимое превышение оценки дисперсии остатков, обусловленных неадекватностью модели, над дисперсией "естественного" разброса случайных наблюдений отклика Y .

     Сообщение состоит из 7 разделов:
   В первом разделе мы позволили себе немого расслабиться и "пофилософствовать" относительно гносеологических и праксеологических отправных точках термина "адекватность".
   Раздел 2 посвящен простым тестам, используемым при анализе гомоскедастичности, случайности и независимости остатков. Как современная альтернатива им предложен метод диагностики модели с использованием кумулятивных остатков, описанный в разделе 3.
   Раздел 4 посвящен анализу данных эксперимента, проводимого с использованием повторностей (т.е. параллельных опытов). Показаны механизм выделения дисперсии "чистой ошибки" отклика и программная реализация теста, оценивающего значимость потерь при подгонке модели (lack of fit).
   Если повторностей в эксперименте нет, то правомочен вопрос: удастся ли составить из выборочных наблюдений однородные группы, которые условно можно назвать "почти параллельными опытами"? В разделах 5 и 6 показана неопределенность и многовариантность результатов кластерного анализа, используемого для этой цели, а также сделан литературный обзор основных стратегических направлений, направленных на получение состоятельной оценки "чистой ошибки" отклика при отсутствии повторностей.
   В разделе 7 рассматриваются функции диагностики адекватности нелинейных моделей, разработанные в пакете drc.
Адрес для доступа к PDF-файлу сообщения -
http://www.ievbras.ru/ecostat/Kiril/R/Blog/11_Adequat.pdf  


суббота, 11 мая 2019 г.

Спецификация модели

Выбор функциональной формы регрессионной модели

В настоящем сообщении обсуждаются три распространенные проблемы, возникающие при выборе спецификации регрессионной модели.
1. Можно ли ограничиться обыкновенной линейной регрессией для описания зависимости Y = f(X) или необходимо выполнить поиск наиболее адекватной нелинейной модели?
Действительно, далеко не всегда, вглядываясь в размытое облако экспериментальных точек на графике Y-X, можно с уверенностью принять однозначное решение. Выборочная оценка коэффициента корреляции или статистическая значимость коэффициента угла наклона не могут помочь нам в этом вопросе. Мы приводим скрипты для расчета корреляционного отношения и проверки статистической гипотезы о линейности функциональной связи на его основе. Другим вариантом теста на линейность спецификации модели является проверка по Фишеру отношения остаточной дисперсии к дисперсии воспроизводимости отклика (оценка потерей при подгонке lack of fit ).

2. Насколько можно доверять оценкам статистической значимости параметров модели?
Обычно превалирует грубое эмпирическое правило - отбросить переменные, статистическая значимость которых превысит 5% порог. К сожалению, существует много нюансов, усложняющих выполнение процедуры Вальда: гетероскедастичность ошибок, сингулярность ковариационных матриц, оценка реальной доли отброшенных переменных в остатках, проблема величины штрафа за усложнение модели и др. Оценки значимости также могут существенно колебаться от объема выборки (числом измерений можно "купить" любую статистическую значимость), последовательности включения предикторов в модель и т.д. Возникает опасность потери членов модели, важных для последующего использования.
Мы показываем некоторые результаты имитации оценок значимости коэффициентов на примере полиномиальной модели (по отдельности или для их комбинаций), а также возможность использования обобщенного метода наименьших квадратов и некоторых схем исправления ковариационной матрицы для получения робастного решения. Приведен пример расчета бутстреповских оценок значимости коэффициентов.

3. Что может быть критерием для вывода о правильности выбранной нами функциональной формы?
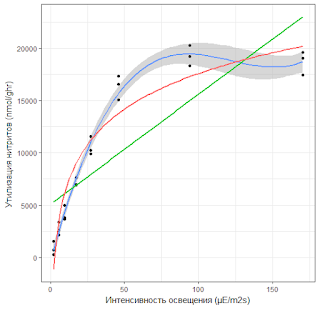
Таких критериев несколько, но ни один из них не является в полной мере работоспособным. Мы предлагаем простую (и, вероятно, дискуссионную) процедуру - использовать в качестве "эталона" непараметрическую модель, построенную на основе ядерных функций, сплайнов или локальной регрессии LOESS. Эта процедура проста и иллюстративна. На первом этапе строится непараметрическая модель и находятся ее 95%-ные доверительные интервалы. Далее, для каждой модели-претендента проводится эмпирическая линия регрессии и, если она целиком помещается в пределах доверительной полосы модели сглаживания, то спецификация параметрической модели является верной. Попутно мы показываем некоторые иные возможности непараметрических моделей с использованием пакета np.

Адрес для доступа к PDF-файлу сообщения -
http://www.ievbras.ru/ecostat/Kiril/R/Blog/10_NonLinear.pdf 

четверг, 28 марта 2019 г.

Многомерный анализ

Многомерная ординация и каноническая корреляция


Приведен обзор многомерных методов, используемых для анализа структуры экологических сообществ. Основные алгоритмы и процедуры систематизированы в виде таблицы, снабженной необходимыми литературными ссылками.
 
На конкретном примере подробно показано использование методов "новой волны", в том числе:
  • Регрессия и дискриминантный анализ с использованием частных наименьших квадратов PLS-R и PLS-DA (Partial Least Squares);
  • Обобщенный канонический корреляционный анализ с регуляризацией (RGCCA - Regularized generalized canonical correlation analysis);
  • Совместный инерционный анализ (CIA, Co-Inertia Analysis) и обобщенный прокрустов анализ;
  • Интегрированный анализ данных с использованием латентных структур DIABLO, который является комбинацией методов PLS-DA и RGCCA и позволяет эффективно проводить анализ коррелированных наборов данных высокой размерности.
Продемонстрированы все этапы анализа: технология построения моделей, оценка их статистической значимости, интерпретация полученных результатов и графическое сопровождение. В качестве примера использовались результаты гидробиологической съемки зоопланктона и бентоса на малых реках с разным уровнем минерализации.

Адрес для доступа к PDF-файлу сообщения -
http://www.ievbras.ru/ecostat/Kiril/R/Blog/9_MDM.pdf  

суббота, 1 декабря 2018 г.

Толерантные интервалы

Построение толерантных интервалов

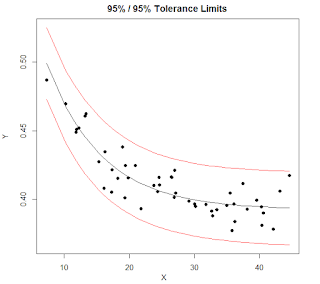
  В сообщении рассматриваются методы построения толерантных интервалов на основе данных, полученных из различных статистических распределений и моделей, в том числе :
  •  одномерное и двумерное нормальное распределение;
  •  различные параметрические непрерывные распределения (равномерное,  экспоненциальное, Гамма, Вейбулла, логистическое);
  • биномиальное и пуассоновское дискретные распределения;
  • модель двухфакторного дисперсионного анализа;
  • различные формы линейной, нелинейной и непараметрической  регрессии;
  • модели Ципфа-Мандельброта.
 Основой сообщения является перевод статьи Young D. S. tolerance: An R Package for Estimating Tolerance Intervals // Journal of Statistical Software. 2010. V. 36(5) . P. 1-39.
Приведены основные принципы оценки толерантных интервалов или расчетные формулы, а также примеры расчета с использованием функций пакета  tolerance  и их графическое сопровождение.


 Адрес для доступа к PDF-файлу сообщения -
  www.ievbras.ru/ecostat/Kiril/R/Blog/8_Tolerance.pdf